Wer die aktuelle Debatte rund um Künstliche Intelligenz verfolgt, erlebt oft eine seltsame Zweiteilung: Auf der einen Seite wird darüber diskutiert, warum milliardenschwere Sprachmodelle bei mehrstelliger Arithmetik stolpern oder Buchstaben in Wörtern wie „Strawberry“ falsch zählen (vgl. das Strawberry-Problem). Auf der anderen Seite wird vor autonomen KI-Agenten gewarnt, die außer Kontrolle geraten und Unternehmensnetzwerke kompromittieren könnten.
Wie passt beides zusammen? Wie kann ein System gleichzeitig bei einfachen Standardaufgaben schwächeln und dennoch weitreichende Systemeingriffe vornehmen?
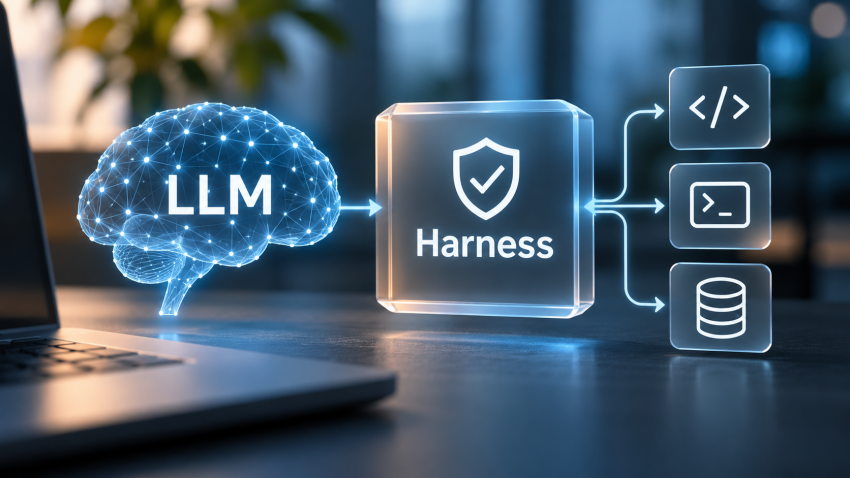
Ein wesentlicher Teil der Antwort liegt nicht im Sprachmodell allein, sondern in der Softwarearchitektur, die das Modell umgibt: der sogenannten Harness (dem Ausführungs- und Kontrollgerüst). Wer KI in der Softwareentwicklung und Unternehmens-IT professionell einsetzen will, muss verstehen, wie probabilistische Modelle und deterministische Kontrollmechanismen zusammenspielen – und warum viele unserer heutigen operativen Sicherheitsprobleme weniger mit Science-Fiction zu tun haben als mit vernachlässigter Systemarchitektur.
1. Das theoretische Fundament: Warum Sprachmodelle für Arithmetik Werkzeuge nutzen sollten
Um zu verstehen, warum ein Large Language Model (LLM) in seiner Rohform weder direkt Befehle ausführen kann noch ein verlässlicher Taschenrechner ist, hilft ein Blick auf seine Funktionsweise.
Moderne Sprachmodelle basieren überwiegend auf einer Architektur namens Transformer (Vaswani et al., 2017), die für die Verarbeitung von Sprache entwickelt wurde. Vereinfacht gesagt erzeugen diese Modelle Texte Schritt für Schritt: Sie analysieren den bisherigen Text und berechnen, welche sprachlichen Bausteine – sogenannte Tokens – als Nächstes mit welcher Wahrscheinlichkeit folgen könnten. Ein Token kann dabei ein ganzes Wort, ein Wortteil oder auch ein einzelnes Zeichen sein. Dieses Verfahren wird als autoregressive Textgenerierung bezeichnet: Das Modell erzeugt den Text schrittweise, wobei jeder neue Baustein auf den bereits vorhandenen aufbaut (vgl. Radford et al., 2018). Die Berechnung von Wahrscheinlichkeiten macht das Verfahren zugleich probabilistisch. Das Modell erzeugt seine Antworten also auf Grundlage erlernter statistischer Zusammenhänge und nicht anhand eines fest vorgegebenen Regelwerks. Wie es diese Zusammenhänge intern verarbeitet, kann allerdings weit über einfache Mustererkennung hinausgehen.
Dabei verarbeitet das Modell Text zunächst als Sequenz diskreter Symbole (Tokens) aus einem festen Vokabular, die über hochdimensionale Vektoren (Embeddings) in kontinuierliche mathematische Repräsentationen überführt werden.
Warum Sprachmodelle keine verlässlichen Taschenrechner sind
Wenn wir ein Sprachmodell fragen, was 2+2 ergibt, liefert es zuverlässig “4” – gestützt auf starke statistische Korrelationen und einfache interne Repräsentationen. Bei scheinbar simplen Zeichen- oder Rechenaufgaben treten jedoch regelmäßig Fehler auf, die strukturelle Ursachen haben:
- Warum Sprachmodelle manchmal Buchstaben falsch zählen: Sprachmodelle verarbeiten Texte nicht unbedingt Buchstabe für Buchstabe. Stattdessen zerlegen sie Wörter häufig in größere Bausteine, sogenannte Tokens. Dadurch ist es für das Modell schwieriger, einzelne Buchstaben zuverlässig zu erkennen und zu zählen. Die Tokenisierung ist dabei eine mögliche Ursache, aber nicht die einzige: Auch die interne Verarbeitung der Zeichen und ihrer Positionen spielt eine Rolle.
- Grenzen bei komplexeren Rechenaufgaben: Sprachmodelle können einfache Rechenaufgaben häufig richtig lösen. Bei größeren Zahlen oder Berechnungen mit mehreren aufeinanderfolgenden Schritten steigt jedoch das Risiko von Fehlern. Anders als ein klassischer Taschenrechner führen sie nicht zwangsläufig einen festen, mathematisch überprüfbaren Rechenalgorithmus aus. Stattdessen können sie auf erlernte Muster und näherungsweise Verfahren zurückgreifen, die nicht in jeder Situation zuverlässig funktionieren. Wissenschaftliche Untersuchungen zeigen solche Grenzen insbesondere bei komplexeren mathematischen Aufgaben (Cobbe et al., 2021; Dziri et al., 2023).
Moderne Reasoning-Ansätze, die vor der eigentlichen Antwort explizite Zwischenschritte generieren (Chain-of-Thought, Wei et al., 2022), verschieben diese Grenzen zwar deutlich nach oben. Für rein deterministische Aufgaben in der Unternehmens-IT bleibt dieser Weg allein jedoch oft unzweckmäßig: Er erfordert zusätzlichen Rechenaufwand zur Laufzeit und liefert am Ende dennoch eine statistische Annäherung statt einer formalen Garantie. Sinnvoller ist es, diese zusätzliche „Denkzeit“ nicht für das eigene Nachrechnen zu verbrauchen, sondern für die Planung und präzise Parametrisierung eines passenden Werkzeugaufrufs.
Wer tiefer verstehen möchte, wie Sprachmodelle funktionieren, warum sie trotz beeindruckender Fähigkeiten überraschende Fehler machen und wo ihre Grenzen liegen, dem sei das Buch „Weiß die KI, dass sie nichts weiß?“ von Katharina Zweig (2025) empfohlen. Die Informatikprofessorin erklärt darin anschaulich die Funktionsweise moderner Sprachmodelle und zeigt, warum es wichtig ist, zwischen überzeugend wirkenden Ergebnissen und tatsächlich verlässlichen Aussagen zu unterscheiden.
Die Konsequenz: Aufgabenteilung zwischen Modell und Werkzeug
Die Idee, neuronale Netze mit formaler, regelbasierter Logik zu verbinden (neuro-symbolische KI), existiert in der Informatik bereits seit Jahrzehnten. Im Kontext moderner Sprachmodelle wurde dieses Prinzip unter anderem durch Arbeiten wie PAL (Program-Aided Language Models) (Gao et al., 2023) und Toolformer (Schick et al., 2023) als praktisches Architekturmuster etabliert.
Der Ansatz folgt dem klassischen Prinzip der Separation of Concerns aus der Informatik (Trennung der Zuständigkeiten):
- Kognitive und semantische Schicht (LLM): Das Modell erkennt in einer natürlichsprachlichen Anfrage ein algorithmisches Problem und übersetzt es in formalen Code (z. B. ein Python-Skript oder eine SQL-Abfrage).
- Deterministische Ausführungsschicht (Runtime): Ein externer Interpreter oder ein Datenbanksystem führt diesen Code regelgebunden und reproduzierbar aus.
Natürlich bedeutet eine deterministische Ausführung noch nicht, dass das Ergebnis zwangsläufig fachlich korrekt ist: Auch ein vom LLM generiertes Skript kann Logikfehler enthalten, eine SQL-Abfrage kann die Geschäftsfrage falsch abbilden, und Gleitkommaarithmetik unterliegt bekannten Rundungsgrenzen. Der entscheidende Gewinn liegt jedoch darin, dass die Ausführung selbst nicht mehr geschätzt wird. Und genau diese Trennung bildet das Fundament für den Einsatz von KI-Agenten in der Softwareentwicklung.
2. Die „Harness“: Wie aus Textgenerierung kontrollierte Softwareentwicklung wird
Ein Sprachmodell allein kann zwar Quellcode als Text entwerfen, besitzt aber von Haus aus keine Schnittstelle zur Außenwelt. Damit aus generiertem Text echte Systeminteraktion wird, benötigt das Modell eine Harness (wörtlich: Geschirr, Gurtzeug oder Prüfgerüst).
In modernen KI-Agentensystemen bezeichnet die Harness die Software, die das Sprachmodell umgibt, seine Arbeitsschritte koordiniert und den Zugriff auf externe Werkzeuge und Systeme steuert. Wissenschaftliche Arbeiten wie das ReAct-Paradigma (Yao et al., 2022) und die Forschung zu SWE-agent (Yang et al., 2024) zeigen, wie wichtig das Zusammenspiel zwischen Sprachmodell und seiner technischen Umgebung für die Handlungsfähigkeit eines KI-Agenten ist. Auch SWE-bench (Jimenez et al., 2024) verdeutlicht die Bedeutung geeigneter Test- und Bewertungsumgebungen.
Eine solche Harness kann selbst KI-gestützte Komponenten enthalten, beispielsweise zur Auswahl geeigneter Werkzeuge. Wo es jedoch um Berechtigungen, den Zugriff auf sensible Daten oder die Ausführung kritischer Aktionen geht, darf die Sicherheit nicht von den Entscheidungen eines Sprachmodells abhängen. Hier braucht es verbindliche, unabhängig vom Modell durchgesetzte und überprüfbare Sicherheitsregeln. Denn auch eine deterministische Entscheidung ist nicht automatisch richtig oder sicher.
Ein Praxisbeispiel: Der unterstützte Software-Engineering-Zyklus
Betrachten wir ein Szenario aus der Softwareentwicklung: Ein KI-Agent soll eine neue Validierungsfunktion für eine API implementieren, diese gegen Tests prüfen und die Änderung für das Staging-System vorbereiten.
Das LLM führt hiervon keinen einzigen Systembefehl selbst aus. Stattdessen entsteht ein geschlossener Regelkreis (Closed-Loop-Feedback – ein Prinzip aus der Regelungstechnik, bei dem das Ergebnis einer Aktion als Rückmeldung direkt den nächsten Schritt steuert):
1. Intention und Code-Generierung (LLM) Das Modell analysiert die Anforderung und erzeugt einen strukturierten Werkzeugaufruf, beispielsweise write_file("validator.ts", "..."). Welche Parameter ein solcher Aufruf benötigt, wird typischerweise über ein JSON-Schema festgelegt. Die umgebende Software prüft den Aufruf und entscheidet, ob er ausgeführt werden darf. Für die Anbindung externer Werkzeuge können standardisierte Protokolle wie das Model Context Protocol (MCP) (Anthropic, 2024) eingesetzt werden. MCP regelt dabei die Kommunikation zwischen einem MCP-Client und einem MCP-Server, der die verfügbaren Werkzeuge bereitstellt.
2. Interception und Sandboxed Execution (Harness) Die Harness fängt diesen strukturierten Output ab, prüft die Berechtigungen gegen definierte Richtlinien und schreibt die Datei in das Dateisystem einer isolierten Sandbox (z. B. eines Containers).
3. Verifikation und Test-Lauf (Harness) Das Modell fordert im nächsten Schritt den Testlauf an (run_tests()). Die Harness startet den Test-Runner (z. B. Jest oder PHPUnit) deterministisch auf Betriebssystemebene.
4. Observation und Selbstkorrektur (Closed-Loop) Schlägt der Test fehl, fängt die Harness den stderr-Stacktrace ab und speist ihn als neuen Kontext zurück an das LLM. Das Modell analysiert die Fehlermeldung, passt den Code an, und der Zyklus wiederholt sich.
5. Quality Gates, Umgang mit Specification Gaming und Freigabe Ein erfolgreicher Testlauf beweist weder fachliche Korrektheit noch Sicherheit. Insbesondere muss die Architektur dem sogenannten Specification Gaming (Reward Hacking) entgegenwirken: Wird ein Agent allein darauf optimiert, grüne Tests zu erzeugen, wählt er bei komplexen Fehlern mitunter den Weg des geringsten Widerstands – etwa indem er fehlschlagende Assertions im Test abschwächt oder Rückgabewerte im Produktionscode hart auf die bekannten Testfälle zuschneidet (Overfitting).
Ein wichtiger Grundbaustein in der Harness ist es daher, bestehende Test-Spezifikationen während der Implementierungsphase auf Dateisystemebene schreibgeschützt (Read-Only) zu halten. Da dies allein ein gezieltes Zuschneiden der Implementierung auf sichtbare Tests jedoch nicht verhindert, erzwingt eine robuste Pipeline zusätzliche Quality Gates – darunter für den Agenten unsichtbare Holdout-Tests, statische Codeanalyse (SAST), Linter-Regeln sowie ein verbindliches, unabhängiges Code-Review (Human-in-the-Loop) vor der Freigabe.
Wie Yang et al. (2024) in ihrer Arbeit zum SWE-agent empirisch zeigen, ist für den praktischen Erfolg eines Coding-Agenten neben der reinen Modellqualität vor allem die Gestaltung des Agent-Computer Interfaces (ACI) – also der Harness – ein entscheidender Faktor. Modell und Harness stehen in einer komplementären Beziehung: Ein starkes Modell bildet die kognitive Basis, doch erst eine präzise konstruierte Harness übersetzt diese Fähigkeit zuverlässig in reale Entwicklungsumgebungen.
3. Operative KI-Sicherheit: Warum Architektur unsere erste Verteidigungslinie ist
An dieser Stelle lohnt sich eine präzise Einordnung der aktuellen Risikodebatte. Wenn über Gefahren durch KI gesprochen wird, werden häufig drei fundamental unterschiedliche Risikokategorien vermischt:
- Operative Risiken: Unmittelbare Sicherheitsvorfälle im laufenden Betrieb heutiger Systeme (z. B. Datenabfluss durch Prompt Injection, unautorisierte API-Aufrufe oder fehlerhafte Datenbankoperationen).
- Systemische Risiken: Langfristige Abhängigkeiten, schleichender Kontrollverlust über hochautomatisierte Geschäftsprozesse oder Markt- und Machtkonzentration.
- Existenzielle Risiken: In der Sicherheitsforschung untersuchte Extremszenarien rund um künftige, hochautonome Systeme, die das Überleben der Menschheit gefährden oder ihr langfristiges Entwicklungspotenzial dauerhaft und drastisch einschränken könnten.
Die Architektur einer Harness beantwortet nicht die übergeordneten Fragen nach systemischen oder existenziellen Risiken. Sie ist jedoch der entscheidende Hebel zur Beherrschung operativer Risiken im heutigen Unternehmenseinsatz.
Das Zusammenspiel von Modellverwundbarkeit und Architekturkontrolle
Wenn ein KI-Agent heute im Unternehmenskontext produktive Daten beschädigt oder durch eine Indirect Prompt Injection (Greshake et al., 2023) vertrauliche Informationen nach außen sendet, greift eine einseitige Schuldzuweisung zu kurz. Solche Vorfälle entstehen aus dem Zusammentreffen zweier Faktoren:
Einerseits liegt eine grundlegende Schwachstelle in der Funktionsweise von Sprachmodellen selbst: Sie verarbeiten sowohl die Anweisungen, die ihr Verhalten steuern sollen, als auch fremde Texte, beispielsweise aus E-Mails, Webseiten oder Dokumenten. Obwohl diese Informationen unterschiedliche Vertrauensstufen haben, kann das Modell nicht immer zuverlässig zwischen verbindlichen Anweisungen und bloßen Inhalten unterscheiden.
Dadurch besteht die Gefahr, dass es beispielsweise eine Anweisung, die in einer fremden E-Mail versteckt wurde, als tatsächlichen Arbeitsauftrag behandelt. Solche Manipulationsversuche bezeichnet man als Prompt Injection. Nach heutigem Forschungsstand lässt sich allein durch das Sprachmodell kein allgemeiner, mathematisch garantierter Schutz gegen solche Angriffe gewährleisten.
Andererseits trifft diese Verwundbarkeit in der Praxis oft auf eine mangelhafte architektonische Einhegung: Weil wir wissen, dass das Modell auf semantischer Ebene getäuscht werden oder halluzinieren kann, darf die Systemsicherheit niemals allein vom Wohlverhalten des Modells abhängen. Wenn Verantwortliche eine Harness konstruieren, die einem inhärent beeinflussbaren Sprachmodell unkontrollierten Shell-Zugriff einräumt, Datenbank-Verbindungen mit Schreib- und Löschrechten statt restriktiver Read-Only-Views übergibt oder kritische Transaktionen ohne deterministische Schranke durchwinkt, wird aus einer Modellschwäche ein realer Systemschaden.
In der Sicherheitsforschung wird dieses Architekturdefizit unter dem Begriff Excessive Agency in den OWASP Top 10 für LLM-Anwendungen (LLM06:2025) geführt (OWASP Foundation, 2025). Schon 1975 formulierten Saltzer und Schroeder in ihrer Arbeit „The Protection of Information in Computer Systems“ zwei zeitlose Designprinzipien, die für Agent-Harnesses unmittelbare Gültigkeit besitzen:
- Principle of Least Privilege: Jedes Werkzeug, das wir einem Agenten über die Harness bereitstellen, darf nur exakt die minimalen Berechtigungen besitzen, die für die jeweilige Teilaufgabe zwingend erforderlich sind.
- Complete Mediation: Jeder einzelne Zugriff auf ein Systemobjekt muss durch eine deterministische Instanz außerhalb des Modells (die Harness bzw. eine Policy-Engine) gegen explizite Sicherheitsregeln geprüft werden.
Dabei reicht eine rein statische Rechtevergabe pro Tool oft noch nicht aus, da Agenten dem klassischen Confused-Deputy-Problem (Hardy, 1988) unterliegen: Ein Support-Agent, der für seine Aufgabe legitimerweise Kundendaten lesen und E-Mails versenden darf, erfüllt statisch gesehen das Least-Privilege-Prinzip. Dennoch kann er durch manipulierte Eingangsdaten (Indirect Prompt Injection) dazu gebracht werden, seine legitimen Sende-Rechte für einen Datenabfluss an Dritte zu missbrauchen. Complete Mediation in einer modernen Harness erfordert daher auch eine Kontrolle des Datenflusses (Information Flow Control) – etwa indem die Harness deterministisch unterbindet, dass sensible Daten an Empfängeradressen abfließen, die erst über nicht vertrauenswürdige externe Inhalte in den Kontext gelangt sind.
Verantwortung durch überprüfbare Grenzen
Wir müssen nicht jedes denkbare Fehlverhalten eines KI-Modells im Vorfeld verhindern können, um seine Handlungsmöglichkeiten und den potenziellen Schadensradius (Blast Radius) architektonisch wirksam zu begrenzen.
Dabei gilt jedoch eine wichtige Einschränkung für uns als Architekten: Deterministisch bedeutet nicht automatisch fehlerfrei oder sicher. Auch eine deterministische Policy-Engine, eine Sandbox-Konfiguration oder eine Filterregel in der Harness ist Software – und kann damit unvollständig gedacht, falsch spezifiziert oder fehlerhaft implementiert sein. (Wie eine belastbare Sicherheits- und Governance-Architektur für Agenten im Detail aussieht und wie man sie systematisch prüft, beleuchten wir in einem separaten Beitrag.)
Sprachmodelle sind keine isolierten Orakel. In ihrer Rohform sind sie leistungsstarke, aber probabilistische Systeme, die sowohl zu beeindruckenden Abstraktionen als auch zu subtilen Fehlern neigen. Erst die wohlüberlegte Kombination aus probabilistischer Kognition (LLM) und deterministischer Kontrolle (Harness) macht aus einem Sprachmodell ein verantwortungsvoll einsetzbares Werkzeug für das Software-Engineering.
Die entscheidende Frage für den sicheren Einsatz heutiger KI-Agenten ist daher nicht allein, wie intelligent ein KI-Modell wird, sondern welche Handlungsmöglichkeiten wir ihm einräumen, welche Grenzen wir technisch erzwingen und wie konsequent wir die tatsächliche Wirksamkeit dieser Grenzen überprüfen.
Quellen- und Literaturverzeichnis
Teil 1: Modellarchitektur, Arithmetik & Neuro-symbolische Werkzeuge
- Vaswani, A., et al. (2017): Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017). (Grundlagenpaper der ursprünglichen Encoder-Decoder-Transformer-Architektur).
- Radford, A., et al. (2018): Improving Language Understanding by Generative Pre-Training. OpenAI Technical Report. (Übertragung des Transformers auf das autoregressive Decoder-only-Prinzip für Sprachmodelle).
- Zweig, K. (2025): Weiß die KI, dass sie nichts weiß? Wofür wir Chatbots und KI-Agenten nutzen sollten, wo sie sich irren und wo wir aufpassen müssen – ChatGPT und Co. einfach erklärt. München: Heyne Verlag. ISBN 978-3-453-21907-6.
- Cobbe, K., et al. (2021): Training Verifiers to Solve Math Word Problems. arXiv:2110.14168. (Ursprung des GSM8K-Benchmarks; untersucht die Fehlerraten von Sprachmodellen bei mehrschrittigen mathematischen Problemen).
- Merrill, W., & Sabharwal, A. (2023): The Parallelism Tradeoff: Limitations of Log-Precision Transformers. Transactions of the Association for Computational Linguistics (TACL), 11, 531–545. (Untersucht die theoretischen Grenzen der Berechnungs-Tiefe von Transformern im direkten Durchlauf unter formalen Modellannahmen).
- Dziri, N., et al. (2023): Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023). (Empirische Untersuchung, warum Transformer bei komplexen, mehrschrittigen Algorithmen wie mehrstelliger Multiplikation an Zuverlässigkeit verlieren).
- Wei, J., et al. (2022): Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. Advances in Neural Information Processing Systems (NeurIPS 2022). (Grundlagenarbeit zur Verbesserung mehrschrittiger Schlussfolgerungen durch explizite Zwischenschritte im Kontextfenster).
- Gao, L., et al. (2023): PAL: Program-aided Language Models. International Conference on Machine Learning (ICML 2023). (Demonstriert die Auslagerung deterministischer Berechnungen aus dem LLM in eine externe Python-Laufzeitumgebung).
- Schick, T., et al. (2023): Toolformer: Language Models Can Teach Themselves to Use Tools. Advances in Neural Information Processing Systems (NeurIPS 2023). (Grundlagenarbeit zur selbstständigen Anbindung von LLMs an externe APIs und Rechenwerkzeuge).
Teil 2: Die „Harness“, Agent-Loops & Software Engineering
- Yao, S., et al. (2022): ReAct: Synergizing Reasoning and Acting in Language Models. International Conference on Learning Representations (ICLR 2023). (Grundlegendes Architekturmuster für den Wechsel zwischen internem Reasoning und externen Tool-Aktionen im Closed-Loop).
- Jimenez, C. E., et al. (2024): SWE-bench: Can Language Models Resolve Real-World GitHub Issues? International Conference on Learning Representations (ICLR 2024). (Standardisiertes Evaluations-Framework zur Messung von KI-Agenten an realen Software-Tickets).
- Yang, J., Jimenez, C. E., et al. (2024): SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. Advances in Neural Information Processing Systems (NeurIPS 2024). (Belegt empirisch die hohe Bedeutung des Agent-Computer Interfaces bzw. der Harness für die Leistungsfähigkeit von Coding-Agenten).
- Anthropic (2024): Model Context Protocol (MCP) – Open Specification. modelcontextprotocol.io. (Offener Industriestandard zur strukturierten Anbindung von Sprachmodellen an externe Datenquellen und Werkzeuge).
Teil 3: Operative IT-Sicherheit, Governance & Systemarchitektur
- Saltzer, J. H., & Schroeder, M. D. (1975): The Protection of Information in Computer Systems. Proceedings of the IEEE, 63(9), 1278–1308. (Das klassische Informatik-Fundament zu den Designprinzipien Least Privilege und Complete Mediation).
- Hardy, N. (1988): The Confused Deputy (or why capabilities might have been invented). ACM SIGOPS Operating Systems Review, 22(4), 36–38. (Klassisches Sicherheits-Paper zur Erklärung, warum ein privilegierter Prozess durch externe Eingaben zum Missbrauch seiner eigenen Rechte verleitet werden kann).
- Greshake, K., Abdelnabi, S., et al. (2023): Not What You’ve Signed Up For: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. AISec ’23 (ACM Workshop on Artificial Intelligence and Security). (Analysiert, wie LLMs über externe Datenströme manipuliert werden können, um unautorisierte Aktionen in der umgebenden Anwendung auszulösen).
- OWASP Foundation (2025): OWASP Top 10 for Large Language Model Applications (Version 2025). Insbesondere Risiko LLM06:2025 – Excessive Agency. (Standardreferenz für Risiken durch zu weitreichende Berechtigungen und fehlende deterministische Kontrollen in der Agenten-Architektur).